

Технічний SEO-чекліст 2026: що перевірити самому за годину - і чого чекліст не бачить
Технічний SEO-чекліст потрібен не тоді, коли «все впало», а за місяць до цього - коли категорії ще в індексі, але Search Console уже тихо накопичує рядки «просканована, але не проіндексована». Нижче - 27 пунктів, які керівник інтернет-магазину перевіряє сам, без розробника і платних сервісів, за годину. І окремий розділ про те, чого жоден чекліст не бачить - щоб знати, де закінчується самоперевірка і починається аудит.
Технічне SEO - це все, що визначає, чи зможе пошукова система знайти сторінку, відрендерити її, взяти в індекс і показати у видачі. У 2026 році до цього визначення додалися три речі: метрика INP замість FID у Core Web Vitals, AI-краулери як окремий клас відвідувачів з окремими правилами доступу, і той факт, що AI Overviews та AI Mode живляться тим самим індексом, що й класичний пошук. Тобто «технічка» тепер ще й квиток у AI-відповіді - детально в огляді GEO-оптимізації та AI-поверхонь. Ширше визначення - що таке SEO-аналіз сайту загалом - окремим матеріалом; сюди повертайтеся з відкритою Search Console.
Чекліст побудований не за темами, а за етапами обробки сайту пошуком: сканування → рендеринг → індексація → ранжування → AI-поверхні. Це не косметика: порядок етапів - це і порядок виправлень. Кожен пункт має клас наслідку: Blocking - сторінка не потрапляє в індекс взагалі; Limiting - в індексі, але зі стелею видимості; Degrading - працює, але гірше, ніж могло б. Задовгий Title і noindex у шаблоні - це не дві «помилки».
Це різні планети.

Етап 1. Сканування: чи взагалі пускаєте ви робота
Тут живуть найдешевші у виправленні і найдорожчі в наслідках знахідки. Google документує: robots.txt - не механізм для виключення сторінки з пошуку, а інструмент проти перевантаження сервера. Це табличка на дверях, а не замок. І навпаки: одна зайва директива закриває каталог від обходу - і жодні тексти вже не допоможуть.
# | Що перевірити | Як за 2 хвилини | Норма | Клас |
|---|---|---|---|---|
1 | robots.txt не закриває каталог, категорії, CSS і JS | Відкрити /robots.txt; GSC → Перевірка URL → «Сканування дозволено?» | Заборонені тільки службові розділи | Blocking |
2 | Токени AI-ботів актуальні і відображають три окремі рішення: індексація (OAI-SearchBot, PerplexityBot), перехід за запитом користувача (ChatGPT-User, Claude-User), навчання (GPTBot, Google-Extended) | Прочитати /robots.txt; застарілий токен на кшталт anthropic-ai = знахідка | Кожен токен - свідоме рішення, не копіпаст 2023 року | Limiting |
3 | Сервер не віддає 5xx і 429 справжньому Googlebot | GSC → Налаштування → Статистика сканування → відповіді за кодами | «Проблем з хостом не виникало»; частка 5xx ≈ 0 | Blocking |
4 | Sitemap актуальна: тільки URL з кодом 200 і без noindex, свіжий lastmod | GSC → Файли Sitemap; відкрити /sitemap_index.xml | Жодної дочірньої карти старшої за рік | Degrading |
5 | Неіснуючі адреси віддають 404 або 410, а не 200 з контентом головної | Відкрити вигадану адресу на своєму домені; GSC → Індексування → «Soft 404» | 404/410 | Blocking |
6 | На комерційних URL немає ланцюгів редиректів | Будь-який чекер HTTP-заголовків; GSC → «Сторінка з переадресацією» | Один хоп. Google йде до 10, але кожен зайвий - втрата | Limiting |
7 | Внутрішні посилання ведуть на кінцеві URL, без javascript:void(0) і без змішування «зі слешем / без» | Відкрити код 5 сторінок, пошук по href | Одна форма URL по всьому сайту | Degrading |
Окремо про пункт 2 - його немає в жодному чеклісті з видачі. Google-Extended, за документацією Google, керує лише навчанням Gemini і grounding - «не впливає на включення в Google Search і не є ранжувальним сигналом». Закрити його - легітимне рішення. Закрити OAI-SearchBot і питати, чому ChatGPT не цитує магазин, - уже ні.
Етап 2. Рендеринг: що бачить робот після виконання JavaScript
Google обробляє сторінку в три фази: сканування, рендеринг у черзі, індексація. Для магазину на React або Vue це найчастіша точка, де «на сайті все є», а в індексі - порожня категорія.
# | Що перевірити | Як за 2 хвилини | Норма | Клас |
|---|---|---|---|---|
8 | Ключовий контент і посилання на товари є у відрендереному HTML | GSC → Перевірка URL → «Переглянути проскановану сторінку» → HTML | Назви, ціни, посилання на картки присутні | Blocking / Limiting |
9 | CSS і JS не заблоковані для Googlebot | Там само → «Інші відомості» → заблоковані ресурси | Список порожній | Limiting |
10 | Core Web Vitals у зеленій зоні за польовими даними мобільних: LCP ≤ 2,5 с, INP ≤ 200 мс, CLS ≤ 0,1 | GSC → Core Web Vitals; PageSpeed Insights → блок «Що бачать реальні користувачі» | Три метрики зелені для груп URL каталогу | Degrading |
11 | Мобільна версія повноцінна: той самий контент і ті самі посилання, що на десктопі | Відкрити категорію з телефона; порівняти кількість товарів і фільтрів | Паритет | Limiting |
12 | Зображення: сучасний формат, задані розміри, найважчі не більші за 200-300 КБ | PSI → рекомендації щодо зображень; DevTools → Network | Жодного PNG на 1,5 МБ у каталозі | Degrading |
Пороги CWV взяті з документації web.dev: INP став стабільною Core Web Vital у 2024-му і замінив FID. Якщо ваш підрядник досі показує звіт із FID - це звіт про минуле.

Етап 3. Індексація: найбільше знахідок і найбільше плутанини
Дев’ять пунктів - і сім із них про e-commerce. Фасетні фільтри, пагінація, варіанти товарів, мовні версії - саме тут магазин генерує тисячі URL, про які ніхто не приймав рішення.
# | Що перевірити | Як за 2 хвилини | Норма | Клас |
|---|---|---|---|---|
13 | Немає випадкового noindex у шаблонах комерційних сторінок | GSC → Індексування → «Заборонено тегом noindex» → переглянути список | Тільки службові сторінки | Blocking |
14 | Сторінки з noindex не заблоковані одночасно в robots.txt | Звірити два списки | Не перетинаються. Інакше noindex не спрацює - робот його не побачить | Blocking |
15 | Canonical самопосилальний на основних сторінках; варіанти товару вказують на канонічний товар | Перевірка URL → «Канонічна за версією Google» ↔ «за версією користувача» | Збігаються | Limiting |
16 | Фільтрові URL не плодять індексні дублі: canonical, noindex або параметри - одна стратегія, не три | GSC → Індексування → «Варіант з canonical» / «Дублікат» | Одне правило для всіх фасетів | Limiting |
17 | Пагінація доступна для обходу; сторінки 2+ мають self-canonical (або canonical на сторінку «Показати все», якщо вона є). Жодного canonical зі сторінки 2 на сторінку 1 - так CMS «склеює» пагінацію і вимиває товари з індексу | Відкрити ?page=2: код 200, canonical вказує на саму себе, посилання на товари в HTML | Self-canonical на кожній сторінці пагінації | Limiting |
18 | Товари «немає в наявності» мають одну політику: 200 зі статусом, 301 на категорію або 410 | Вибірка 5 карток; GSC → «Soft 404» | Одна політика на весь каталог | Limiting |
19 | hreflang: взаємні пари для всіх мов і x-default; перемикач мови веде на відповідник, а не на редирект | Код 3 пар сторінок | Взаємність без винятків | Limiting |
20 | «Просканована, але не проіндексована» і «Виявлена, не проіндексована»: частка від усіх непроіндексованих і які це URL | GSC → Індексування сторінок → причина → список | Не комерційні сторінки | Сигнал |
21 | URL у sitemap ≈ проіндексовані | GSC → Файли Sitemap: «виявлено» ↔ «проіндексовано» | Розрив не більший за 10-15 % | Сигнал |
Пункти 20 і 21 не мають класу. Це не помилки, це діагноз. Статус «Crawled - currently not indexed» у довідці Search Console означає рівно одне: Google сторінку прочитав і вирішив не брати. Повторно подавати не треба - треба зрозуміти чому. А це вже поза чеклістом, до цього повернемося.

Етап 4. Ранжування і AI-поверхні: коли сторінка вже в індексі
Сторінка в індексі - це нуль, а не фініш. Тут перевіряємо, чи не ставите ви їй стелю самі.
# | Що перевірити | Як за 2 хвилини | Норма | Клас |
|---|---|---|---|---|
22 | Title 50-60 знаків, Description 140-160, один H1 20-70 - на money pages і категоріях | Вибірка 10 URL; для масштабу - десктопний краулер як клас інструментів | Title не обрізається у видачі | Degrading |
23 | Комерційні сторінки входять у топ за внутрішньою вагою | GSC → Посилання → Внутрішні → топ-10 | Категорії і послуги - у топ-10, не «Контакти» і «Політика» | Limiting |
24 | Немає битих посилань і посилань на редиректи у шаблонних блоках (футер, «схожі товари») | GSC → «Сторінка з переадресацією»; краулер | Нуль у шаблонах | Degrading |
25 | HTTPS без змішаного контенту; http → https одним 301 | Консоль браузера; чекер заголовків | Чисто | Limiting |
26 | Ключові сторінки індексовані і мають право на сніпет: без nosnippet і max-snippet:0; для повноти - max-snippet:-1 і max-image-preview:large | Перевірка URL; пошук nosnippet, max-snippet, max-image-preview у коді і в HTTP-заголовку X-Robots-Tag | Сніпет дозволений. Це і є умова показу в AI Overviews і AI Mode - спецфайли і спецрозмітка не потрібні | Limiting |
27 | Структуровані дані валідні, без конфліктних типів на одній сторінці | Rich Results Test; GSC → Покращення | Один тип сутності на сторінку; глибина - у розборі schema для AI-пошуку. | Degrading |
Пункт 26 варто перечитати двічі. Уся «оптимізація під AI», яку пропонують окремим рахунком, у технічній частині зводиться до цих 27 рядків. Решта - контент і зовнішній слід, але це вже зовсім інша…
Чого чекліст не бачить
Тепер чесно.
Чекліст - це термометр, а не рентген: він показує, що температура є, і нічого не каже про причину. Скільки з ваших зелених галочок узагалі про причини? Три речі з цих 27 пунктів не видно в принципі - і ми знаємо це не з теорії, а з логів реального проєкту 2026 року, з яким працювали.
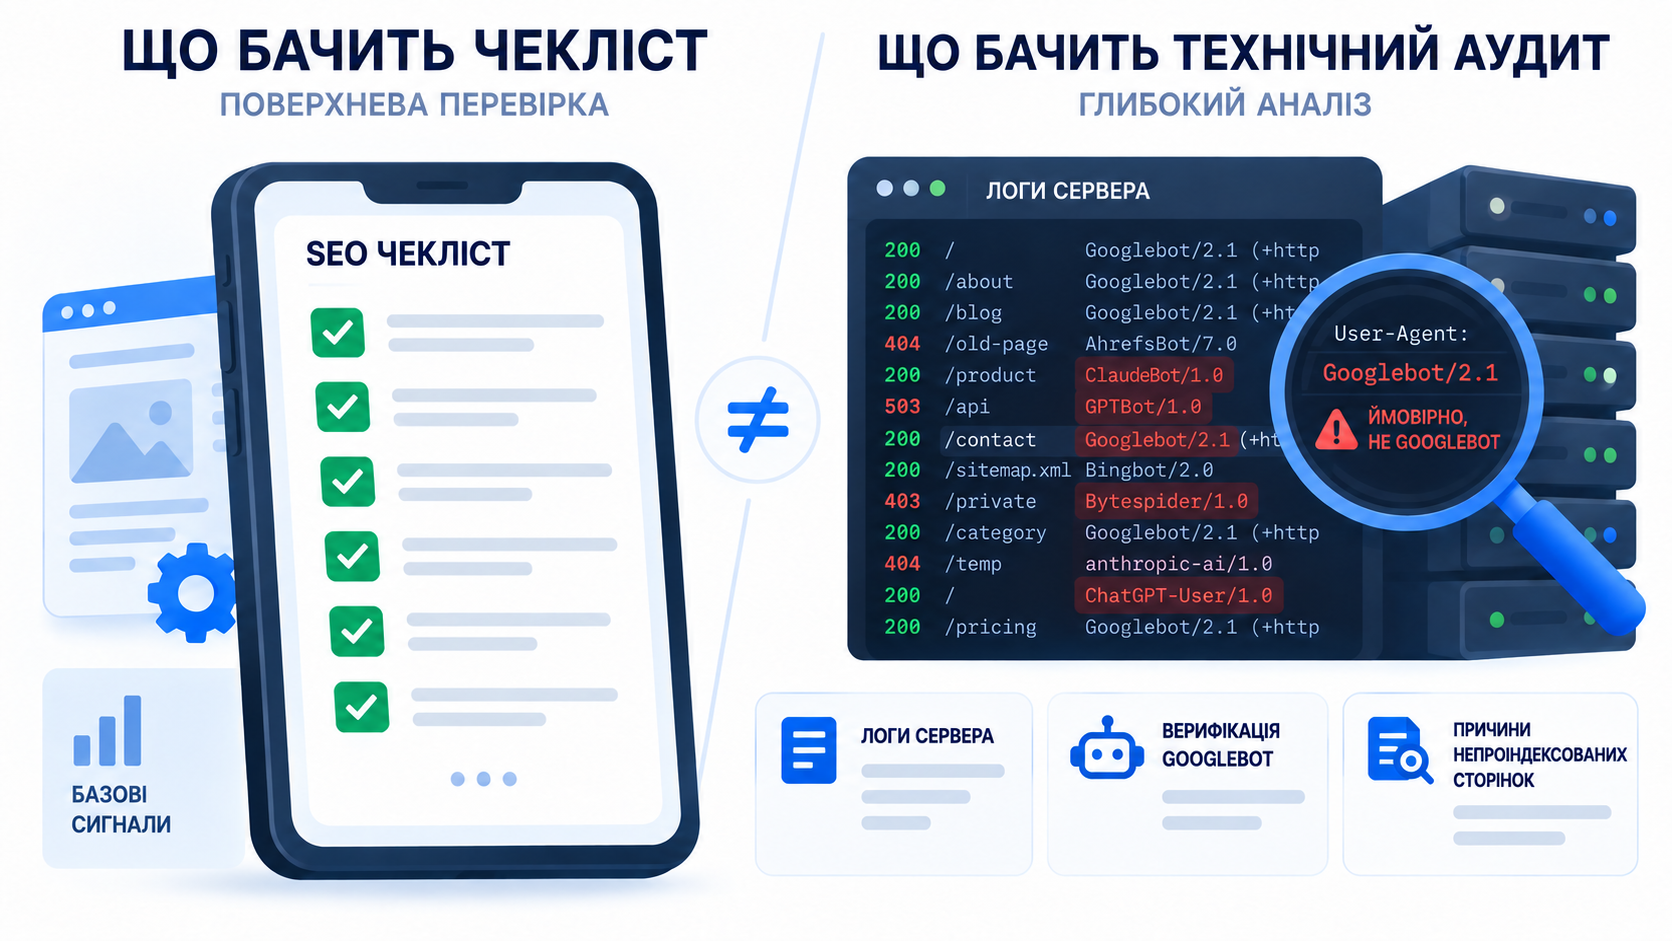
Хто насправді ходить по сайту. У чеклісті ви дивитесь Crawl Stats, і там усе гаразд. А в серверних логах за дві доби з 937 рядків з підписом Googlebot справжніх виявилось 333 - решта 604, з 464 різних IP, підробка. Будь-яка цифра «як часто нас сканує Google», знята за рядком User-Agent, недостовірна за замовчуванням. Google документує єдиний спосіб перевірки - зворотний DNS-запит з наступною прямою перевіркою. Без логів це не зробити.
Куди йде ресурс сервера. На тому ж проєкті 71,9 % усіх запитів за два місяці генерував власний стек оптимізації сайту - плагін кешування і чекер посилань, - сплесками по мільйону запитів за чотири доби. Робот при цьому не постраждав, і Search Console не показала нічого. Але це дізнаєшся тільки з логів.
Чому Google не бере сторінку, яку прочитав. 335 URL зі статусом «просканована або виявлена, не проіндексована» - 76 % усіх непроіндексованих на сайті. Перша гіпотеза завжди «мало тексту». Ми перевірили: 78 % цих сторінок мають достатній обсяг, найбільша група - 107 сторінок по 800-1 500 слів. Справа не в довжині. Справа в тому, як Google оцінює цінність сторінки відносно решти сайту, а це не виміряти жодним пунктом чекліста - тільки перехресним аналізом GSC, логів і повного краулінгу.
Типова історія з практики: інхаус-команда магазину проходить чекліст, усе зелене, а нові категорії два місяці висять поза індексом. Причина знайшлась у логах - і вона не мала жодного стосунку до тих 27 пунктів. Саме для таких випадків і існує технічний аудит, а не для того, щоб повторити чекліст за гроші.
Що бачить чекліст | Що бачить аудит |
|---|---|
robots.txt як текст | Реальна активність кожного бота в логах, з верифікацією за IP |
Статуси в Search Console | Причини за статусами: чому саме ці URL Google вирішив не брати |
Оцінку PageSpeed Insights | Польові дані за сегментами: категорії, картки, мобільні з повільних мереж |
Рядок User-Agent | Зворотний DNS: справжній Googlebot чи 464 підробки |
Одне джерело на кожен пункт | Кожна знахідка підтверджена двома незалежними джерелами |
Що робити зі списком знахідок
У вас буде від 3 до 15 позначок. Не виправляйте «що простіше». Спершу все з класом Blocking - воно повертає сторінки в індекс; потім Limiting - знімає стелю; Degrading - наостанок. Порядок робіт повторює порядок обробки сайту пошуком, інакше ви місяць правите Title на сторінках, яких немає в індексі.
І одразу розвіємо очікування. Строків переіндексації Google не документує, тому будь-яке «за два тижні повернемось у топ» - гіпотеза, а не обіцянка.
Якщо Blocking-знахідок більше трьох, або ви не можете пояснити, чому категорії мають статус «просканована, але не проіндексована», - це вже не чекліст. Це аудит. Як виглядає його результат - пріоритезований план від Critical до Low з оцінкою впливу на дохід, а не PDF на сто сторінок - ми показали на кейсі відновлення видимості інтернет-магазину.
Як ми це робимо в ADS group
ADS group працює з 2011 року: Digital-агентство №1 у Миколаєві, ТОП-30 України, клієнти в Україні та ЄС. Цей чекліст - перший крок нашого технічного аудиту, і ми віддаємо його повністю: 30-40 % знахідок ви закриєте самі. Наша робота починається там, де закінчується видимість ззовні: серверні логи, повний краулінг і правило - жодна знахідка не потрапляє у звіт без підтвердження з двох незалежних джерел. Виправлення веде та сама зв’язка SEO-юніту і розробників, що робила діагностику, - для Magento, Shopify, OpenCart, WooCommerce, а за потреби і розробка сайту під технічні вимоги з першого дня.
Годину - самі, решту - з логами
Коротко. 27 пунктів за чотирма етапами закривають усе, що видно ззовні, - у 2026-му включно з доступом AI-ботів і правом на сніпет. Класи Blocking → Limiting → Degrading задають порядок виправлень. А три речі - справжній Googlebot, розподіл ресурсу і причини «не проіндексовано» - не видно нікому без серверних логів.
Пройшли чекліст і знайшли більше трьох Blocking або незрозумілий провал індексації? Замовте технічний аудит: за 5 робочих днів - пріоритезований план з підтвердженням кожної знахідки двома джерелами і порядком робіт, який повторює порядок обробки сайту пошуком.


