Акт 1. Контекст: стабільна органіка і бізнес-рішення про переїзд
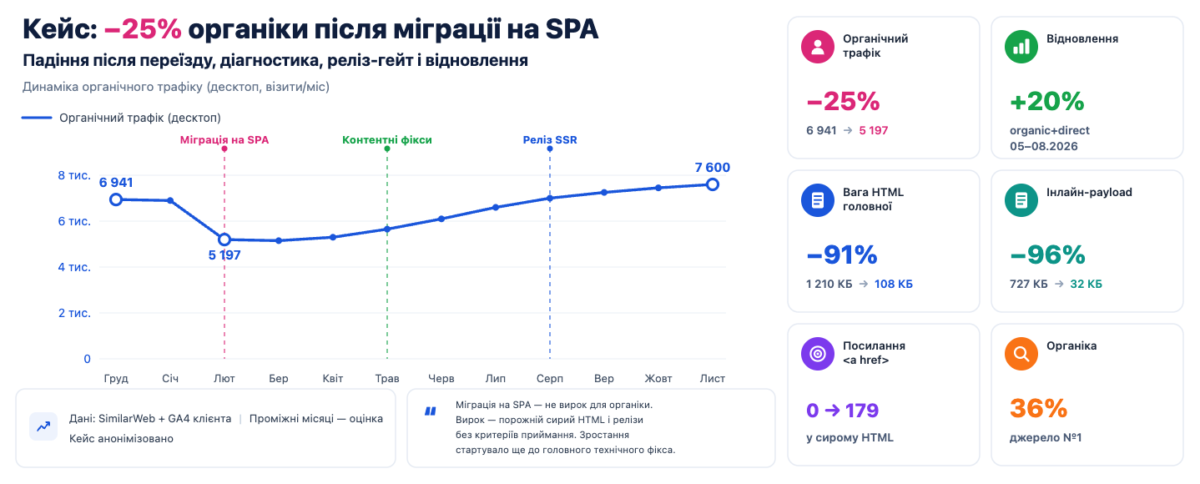
Клієнт - мережа з філіями по Україні: ремонт турбокомпресорів плюс каталог запчастин на ~3000 SKU, двомовний сайт. Органіка стабільна: за SimilarWeb - близько 6 941 десктоп-візитів на місяць. Двигун каналу - категорії й картки товарів: для e-commerce саме вони збирають комерційний попит (як це працює системно - розбирали в гайді про SEO для інтернет-магазинів.
Рішення про переїзд зі старого PHP-сайту на сучасний JavaScript-стек ухвалили з міркувань продукту: швидший інтерфейс, зручність розробки, редизайн. Перша ітерація виглядала так: бекенд - Node.js, фронтенд - SPA на JavaScript із власним, самописним фреймворком. Класична ситуація, яку ми бачимо регулярно: стек обрали з погляду розробки - а SEO-наслідки не прораховував ніхто.
Акт 2. Просадка: -25% трафіку і зупинка зростання
Нову SPA-версію задеплоїли [дата деплою, 01-02.2026]. Одразу після переїзду органічний десктоп-трафік просів на 25%: з ~6 941 до 5 197 візитів на місяць.
Перше, що хочеться сказати в такій ситуації, - «ринок просів». Ми перевірили. Ринок і справді був неспокійний, але неоднорідний:
Сайт | Динаміка 02.2026 |
|---|---|
Клієнт | -25% |
Конкурент №1 | -52% |
Конкурент №2 | +26% |
Один гравець втратив половину, інший - виріс на чверть. Списати все на сезон чи ринок не вийшло. Причину треба було шукати в самому сайті.
І тут важлива чесна деталь, яка відрізняє цей кейс від історій про катастрофу. Сайт не обвалився: за ключовими запитами він загалом утримався в топах. Але він перестав рости - при живому попиті й активному ринку. Для власника така картина часто виглядає як «усе гаразд, просто період такий». Для нас стагнація на тлі збереженого попиту - симптом нездоров’я. Саме вона, а не самі лише -25%, стала сигналом іти в глибокий аудит.
Акт 3. Діагностика: що насправді побачив Googlebot
Тут почалася найважливіша частина кейсу. Ми зняли сторінки за протоколом «сирий HTML без виконання JavaScript» - тобто подивилися на сайт очима бота в момент першого запиту (окрема причина робити це власним протоколом: датацентрові запити сайт відсікав на рівні Cloudflare, тож питання «звідки бачить бот» вимагало окремої перевірки).
Одразу розставимо акценти, бо тут легко перекрутити. Googlebot не був «сліпим»: контент на сайті існував, і після рендерингу JavaScript бот його отримував. Проблема в іншому - контенту не було в HTML. Він жив у JavaScript-контейнері, і цей контейнер тягнув на кожну сторінку майже всю структуру сайту. Первинний аудит звівся до чотирьох знахідок:
- Немає HTML. У сирому HTML - нуль контенту: весь текст, посилання й заголовки сиділи всередині JS-контейнера.
- Бот отримував дані не з першого заходу. Перший запит віддавав порожній каркас; справжній вміст Google бачив лише після рендерингу JavaScript - з черги, яка живе своїм розкладом.
- Великий розмір сторінок. До 1 МБ HTML на сторінку при нормі <150 КБ.
- Відкриті дані для парсингу. JSON-контейнер з контентом і майже повною структурою сайту лежав відкритим на кожній сторінці - будь-який парсер міг зняти каталог і всі SEO-тексти одним запитом.
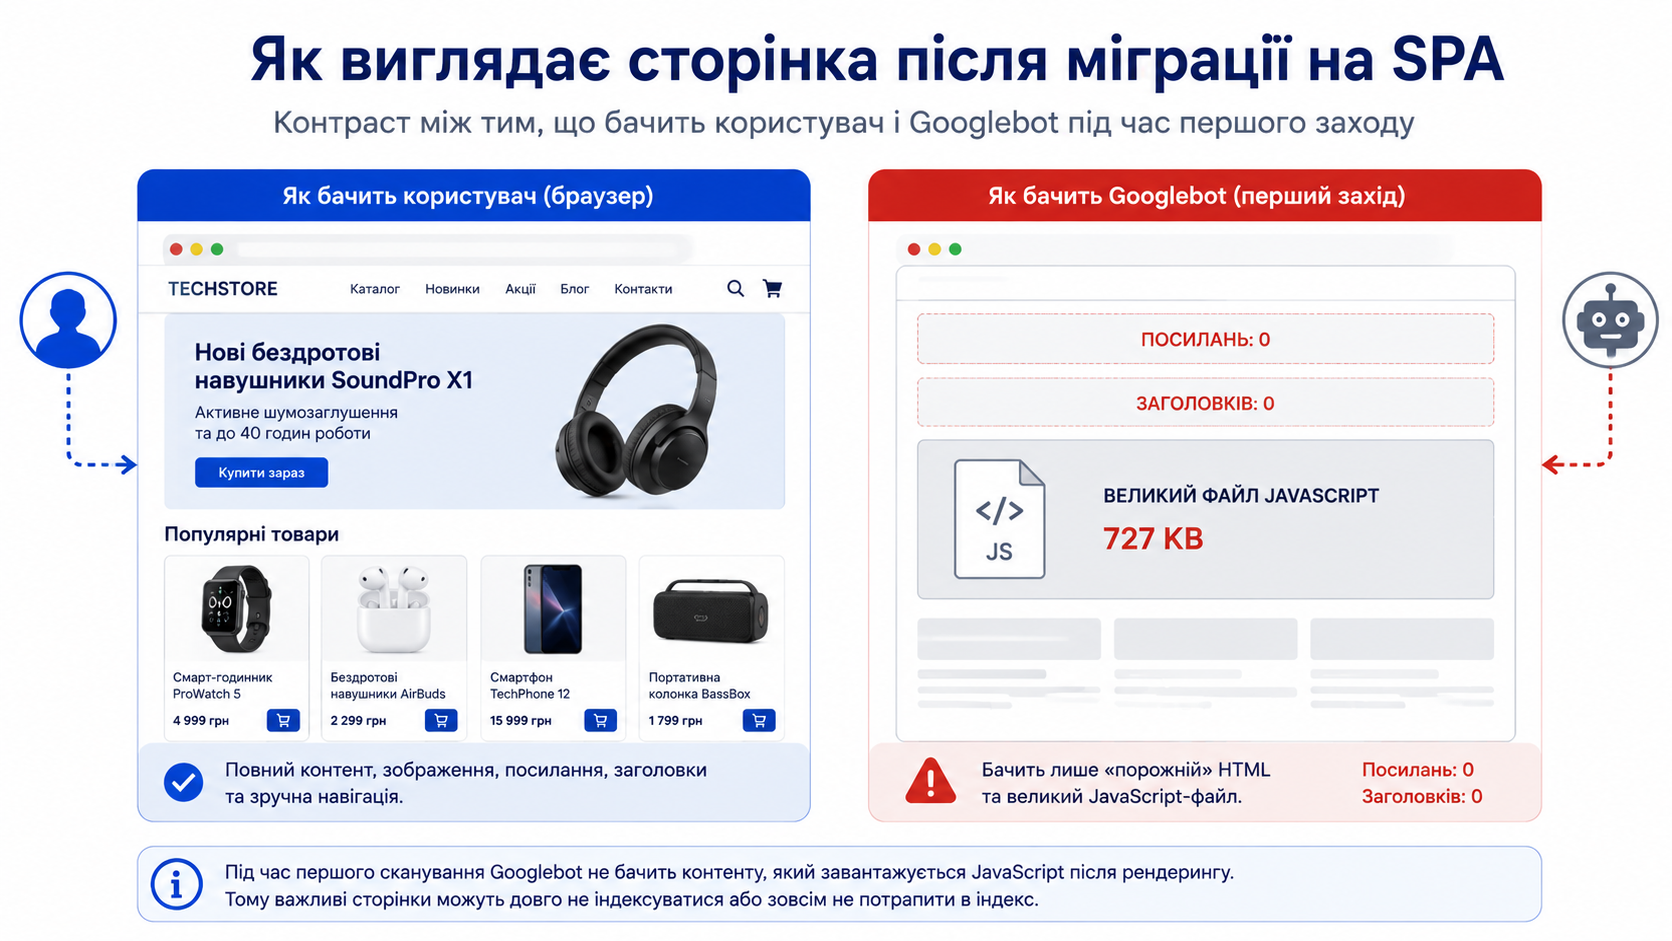
У цифрах перший запит бота виглядав так:
Що перевіряли (сирий HTML) | Факт після переїзду (аудит 03.2026) |
|---|---|
Посилання <a href> у <body> поза <script> | 0 (із 346 на головній для користувача) |
Теги H1 | 0 |
Текст поза скриптами | 0 символів |
Зображення | 0 |
Вага HTML сторінки | до 1 МБ при нормі <150 КБ; /site-map - 5,5 МБ |
Інлайн-payload | 727 КБ в одному скрипті |
Окрема деталь, яку люблять розробники: змінна з усім цим станом називалася ssrdata - але жодного Server-Side Rendering вона не робила.
Масштаб контейнера найкраще показує сторінка послуг: 303 теги H2, з яких по темі - лише 6. Решта - SEO-тексти інших сторінок, що «їхали» в payload меню на кожну сторінку двома мовами (~90 КБ чужого контенту, на сторінці контактів - 26 повних текстів інших розділів). 43% JSON-payload - внутрішні дублі; власний контент сторінки - 2,9%.
Чому це гальмує ріст - механіка простими словами. Google обробляє JavaScript-сайти у фази: сканування сирого HTML відбувається одразу, а рендеринг JavaScript стоїть в окремій черзі, яка може розтягуватися (Google Search Central: Understand JavaScript SEO Basics).
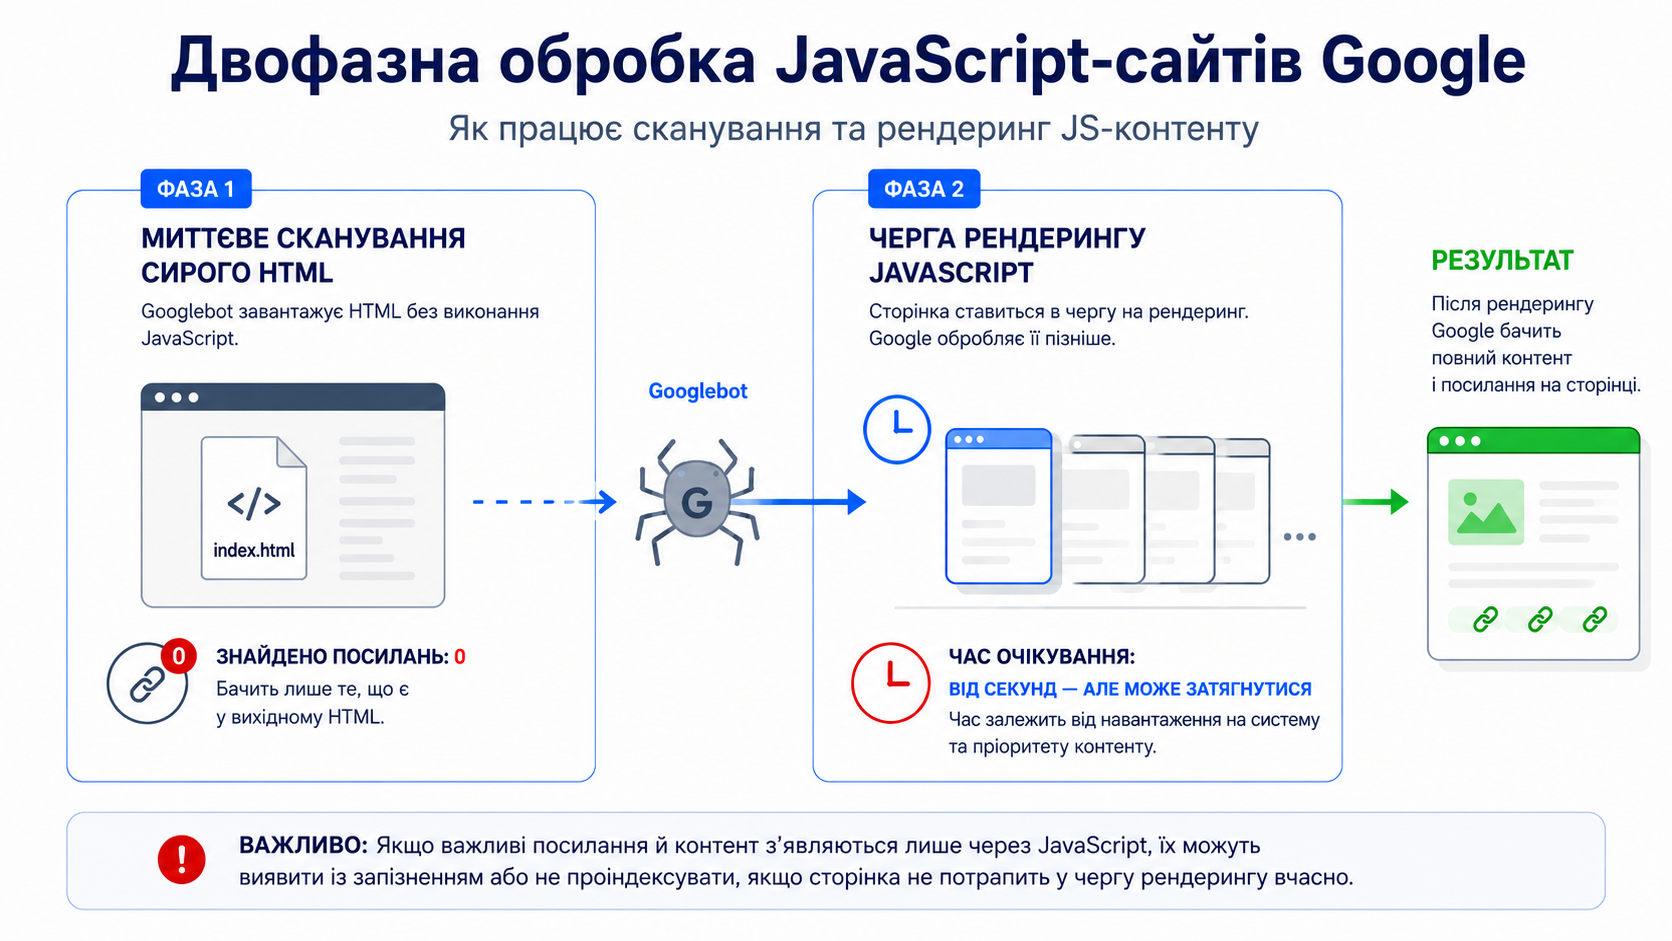
Ключова інженерна деталь: нові URL Google відкриває через посилання, а посилання бот знаходить лише в елементах <a> з атрибутом href. Немає їх у сирому HTML - краулер не може вчасно будувати граф зв’язків для нових і оновлених сторінок: це удар одразу по discovery і краулінговому бюджету. Старі сторінки ранжуються за збереженим історичним індексом - тому топи трималися. А нові посадкові, оновлені картки і свіжі тексти підхоплюються «другим темпом» і зависають «сиротами» - тому росту не було: все нове бот бачив пізно і дорого.
Для фахівців - врізка: у типових провальних міграціях на SPA втрати сягають -60…80% органіки. Тут просадка зупинилася на -25%, і це не везіння. При переїзді команда зберегла 100% URL-структури (нуль 404), коректні hreflang, canonical і Schema.org. Це «міграційна гігієна» - саме вона втримала позиції в топах, поки рендеринг-борг з’їдав потенціал росту. Як ми знаходимо такі речі системно - окремий матеріал: кейс технічного SEO-аудиту.
Акт 4. Програма дій: два паралельні треки
Виправлення розклали на два треки, які йшли одночасно.
Трек А - технічний. Вимоги до розробників: впровадити SSR (H1, текст, меню, посилання на товари й зображення - у сирому HTML до виконання JS); «payload-дієта» - вичистити з пейлоада чужі SEO-тексти, дублікати й невикористовувану мовну версію з планом 727 КБ → 60-90 КБ; виправити soft-404, роздуті title, пагінацію; додати lazy loading і комерційну Schema.org (ItemList / Product / AggregateRating). Команда розробки вирішила закривати ці вимоги другою ітерацією - переписуванням фронтенду з самописного фреймворку на React із SSR.
Трек Б - контентно-структурний. Поки розробники будували SSR, працювали з тим, що не залежить від релізу: нові посадкові під вузькі послуги (актуатор, діагностика) й регіональні сторінки; переоптимізація сторінок під реальний інтент - показовий випадок: сторінка була заточена під «очистку» DPF, а частотний запит ринку - «промивка»; системна робота з відгуками в Google Business Profile.
Local SEO дало найнаочніший урок кейсу. Філія в одному з обласних центрів тримає Local Pack #1 з рейтингом 4.9 і 143 відгуками - проти конкурента з 839 відгуками, але рейтингом 4.3. Якість відгуків важить більше за кількість.
Акт 5. Реліз-гейт: чому ми не пропустили реліз розробників
Коли розробники представили другу ітерацію - фронтенд, переписаний на React із SSR, - її можна було просто випустити. Ми не випустили.
Аудит прототипу за тим самим протоколом сирого HTML показав 9 регресів проти 5 покращень: 50 битих зображень, H1 головної «прибитий» до першого слайда рекламного банера, canonical на чужий хост, відсутній sitemap, конфліктний robots.txt. Другого падіння трафіку бізнес міг і не пережити.
Розробники поспішали. Ми - ні.
Прототип повернули на доопрацювання - не з коментарем «щось не так», а з формальними критеріями приймання, які перевіряються на сирому HTML без виконання JS:
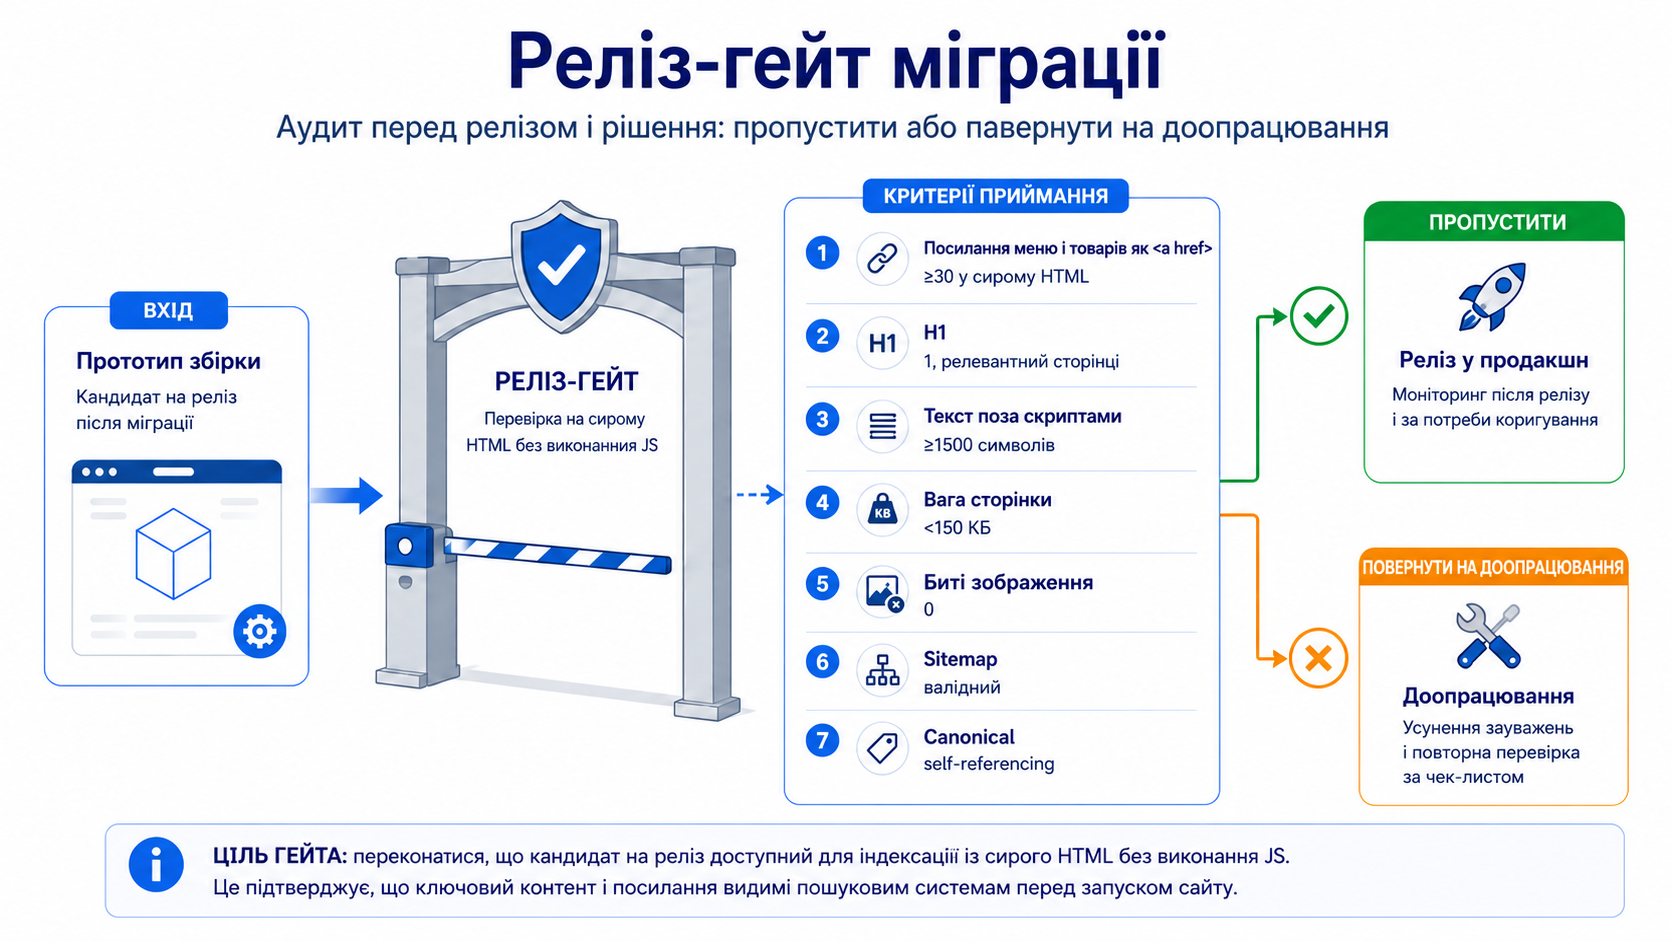
Критерій приймання релізу | Поріг |
|---|---|
Посилання меню й товарів як <a href> | ≥30 у сирому HTML |
H1 | 1, релевантний сторінці |
Текст поза скриптами | ≥1500 символів |
Вага сторінки | <150 КБ |
Биті зображення | 0 |
Sitemap | валідний |
Canonical | self-referencing |
Це і є «реліз-гейт»: страховка, яка коштує один аудит - і завжди дешевша за друге падіння трафіку. Саме тому ми вважаємо, що SEO-вимоги мають сидіти в ТЗ на розробку сайту з першого дня, а не з’являтися після релізу.