

Технический SEO-чеклист 2026: что проверить самому за час - и чего чеклист не видит
Технический SEO-чеклист нужен не тогда, когда «все упало», а месяцем ранее - когда категории еще в индексе, но Search Console уже тихо накапливает строки «просканированная, но не проиндексированная». Ниже - 27 пунктов, которые руководитель интернет-магазина проверяет сам, без разработчика и платных сервисов, в час. И отдельный раздел о том, чего ни один чеклист не видит - чтобы знать, где заканчивается самопроверка и начинается аудит.
Техническое SEO - это все, что определяет, сможет поисковая система найти страницу, отрендерить ее, взять в индекс и показать в выдаче. В 2026 году к этому определению добавились три вещи: метрика INP вместо FID в Core Web Vitals, AI-краулеры как отдельный класс посетителей с отдельными правилами доступа, и тот факт, что AI Overviews и AI Mode питаются тем же индексом, что и классический поиск. То есть «техничка» теперь еще и билет в AI-ответе - подробно в обзоре GEO-оптимизации и AI-поверхностей. Широкое определение - что такое SEO-анализ сайта в общем - отдельным материалом; сюда возвращайтесь с открытым Search Console.
Чеклист построен не по темам, а по этапам обработки сайта поиском: сканирование → рендеринг → индексация → ранжирование → AI-поверхности. Это не косметика: порядок этапов - это и порядок исправлений. Каждый пункт имеет класс следствия: Блокировка - страница не попадает в индекс вообще; Ограничение - в индексе, но с потолком видимости; Унижение - работает, но хуже, чем могло бы. Длинный Title и noindex в шаблоне - это не две «ошибки».
Это разные планеты.

Этап 1. Сканирование: вообще пускаете ли вы робота
Здесь живут самые дешевые в исправлении и наи более дорогие в последствиях находки. Google документирует: robots.txt - не механизм для исключения страницы из поиска, а инструмент против перегрузки сервера. Это табличка на дверях, а не замок. И наоборот: одна излишняя директива закрывает каталог от обхода - и никакие тексты уже не помогут.
# | Что проверить | Как через 2 минуты | Норма | Сорт |
|---|---|---|---|---|
1 | robots.txt не закрывает каталог, категории, CSS и JS | Открыть /роботы.txt; GSC → Проверка URL → «Сканирование разрешено?» | Запрещены только служебные разделы | Блокировка |
2 | Токены AI-ботов актуальны и отображают три отдельных решения: индексация (OAI-SearchBot, PerplexityBot), переход по запросу пользователя (ChatGPT-User, Claude-User), обучение (GPTBot, Google-Extended) | Прочесть /роботы.txt; устаревший токен вроде антропический-ИИ = находка | Каждый токен - сознательное решение, не копипаст 2023 года | Ограничение |
3 | Сервер не отдает 5xx и 429 настоящему Googlebot | GSC → Настройки → Статистика сканирования → ответы по кодам | «Проблем с хостом не возникало»; часть 5xx ≈ 0 | Блокировка |
4 | Sitemap актуальна: только URL с кодом 200 и без noindex, свежий lastmod | GSC → Файлы Sitemap; открыть /sitemap_index.xml | Никакой дочерней карты старше года | Унижение |
5 | Несуществующие адреса отдают 404 или 410, а не 200 с контентом главной | Открыть вымышленный адрес в домене; GSC → Индексирование → «Soft 404» | 404/410 | Блокировка |
6 | На коммерческих URL нет цепей редиректов | Любой чекер HTTP-заголовков; GSC → «Страница с переадресацией» | Один хоп. Google идет до 10, но каждый лишний - потеря | Ограничение |
7 | Внутренние ссылки ведут на конечные URL, без javascript:void(0) и без смешивания «со слешем/без» | Открыть код 5 страниц, поиск по href | Одна форма URL по всему сайту | Унижение |
Отдельно о пункте 2 - его нет ни в одном чеклисте по выдаче. Google-Extended, за документацией Google, управляет только обучением Gemini и grounding - «не влияет на включение в Google Search и не является ранжировочным сигналом». Закрыть его - легитимное решение. Закрыть OAI-SearchBot и спрашивать, почему ChatGPT не цитирует магазин - уже нет.
Этап 2. Рендеринг: видящий робот после выполнения JavaScript
Google обрабатывает страницу в три фазы: сканирование, рендеринг в очереди, индексация. Для магазина на React или Vue это самая частая точка, где «на сайте все есть», а в индексе - пустая категория.
# | Что проверить | Как через 2 минуты | Норма | Сорт |
|---|---|---|---|---|
8 | Ключевой контент и ссылки на товары есть в отрендереном HTML | GSC → Проверка URL → «Просмотр просканированной страницы» → HTML | Названия, цены, ссылки на карты присутствуют | Блокировка / Ограничение |
9 | CSS и JS не заблокированы для Googlebot | Там же → «Другие сведения» → заблокированные ресурсы | Список пуст | Ограничение |
10 | Core Web Vitals в зеленой зоне по полевым данным мобильных: LCP ≤ 2,5 с, INP ≤ 200 мс, CLS ≤ 0,1 | GSC → Core Web Vitals; PageSpeed Insights → блок «Видящие реальные пользователи» | Три метрики зеленые для групп URL каталога | Унижение |
11 | Мобильная версия полноценна: тот же контент и те же ссылки, что на рабочем столе | Открыть категорию с телефона; сравнить количество товаров и фильтров | Паритет | Ограничение |
12 | Изображение: современный формат, заданные размеры, самые тяжелые не более 200-300 КБ | PSI → рекомендации по изображению; DevTools → Network | Ни одного PNG на 1,5 МБ в каталоге | Унижение |
Пороги CWV взяты из документации web.dev: INP стал стабильным Core Web Vital в 2024-м и заменил FID. Если ваш подрядчик до сих пор показывает отчет с FID - это отчет о прошлом.

Этап 3. Индексация: больше всего находок и больше путаницы
Девять пунктов - и семь из них об e-commerce. Фасетные фильтры, пагинация, варианты товаров, языковые версии - именно здесь магазин генерирует тысячи URL, о которых никто не принимал решения.
# | Что проверить | Как через 2 минуты | Норма | Сорт |
|---|---|---|---|---|
13 | Нет случайного noindex в шаблонах коммерческих страниц | GSC → Индексирование → «Запрещено noindex» → просмотреть список | Только служебные страницы | Блокировка |
14 | Страницы из noindex не заблокированы одновременно в robots.txt | Сверить два списка | Не пересекаются. Иначе noindex не сработает - робот его не увидит | Блокировка |
15 | Canonical самоссылающийся на основных страницах; варианты товара указывают на канонический товар | Проверка URL → «Каноническая по версии Google» ↔ «по версии пользователя» | Совпадают | Ограничение |
16 | Фильтровые URL не плодят индексные дубли: canonical, noindex или параметры - одна стратегия, не три | GSC → Индексирование → «Вариант по canonical» / «Дубликат» | Одно правило для всех фасетов | Ограничение |
17 | Пагинация доступна для обхода; страницы 2+ имеют self-canonical (или canonical на странице «Показать все», если она есть). Ни одного canonical со страницы 2 на страницу 1 - так CMS «склеивает» пагинацию и вымывает товары из индекса | Открыть ?page=2: код 200, canonical указывает на себя, ссылки на товары в HTML | Self-canonical на каждой странице пагинации | Ограничение |
18 | Товары «нет в наличии» имеют одну политику: 200 со статусом, 301 на категорию или 410 | Выборка 5 карт; GSC → «Soft 404» | Одна политика на весь каталог | Ограничение |
19 | hreflang: взаимные пары для всех языков и x-default; переключатель языка ведет на соответствие, а не на редирект | Код 3 пар страниц | Взаимность без исключений | Ограничение |
20 | «Просканированная, но не проиндексированная» и «Обнаруженная, не проиндексированная»: доля всех непроиндексированных и какие это URL | GSC → Индексирование страниц → причина → список | Не коммерческие страницы | Сигнал |
21 | URL в sitemap ≈ проиндексированы | GSC → Файлы Sitemap: «обнаружено» ↔ «проиндексировано» | Разрыв не больше 10-15 % | Сигнал |
Пункты 20 и 21 не имеют класса. Это не ошибка, это диагноз. Статус «Crawled - currently not indexed» в справке Search Console означает ровно одно: Google страницу прочитал и решил не брать. Повторно подавать не надо - нужно понять почему. А это уже вне чеклиста, к этому вернемся.

Этап 4. Ранжирование и AI-поверхности: когда страница уже в индексе
Страница в индексе - это ноль, а не финиш. Здесь проверяем, не ставите ли вы ему потолок сами.
# | Что проверить | Как через 2 минуты | Норма | Сорт |
|---|---|---|---|---|
22 | Title 50-60 знаков, Description 140-160, один H1 20-70 - на money pages и категориях | Выборка 10 URL; для масштаба - десктопный краулер как класс инструментов | Title не обрезается в выдаче | Унижение |
23 | Коммерческие страницы входят в топ по внутреннему весу | GSC → Ссылки → Внутренние → топ-10 | Категории и услуги - в топ-10, не «Контакты» и «Политика» | Ограничение |
24 | Нет битых ссылок и ссылок на редиректы в шаблонных блоках (футер, «схожие товары») | GSC → «Страница с переадресацией»; краулер | Нуль у шаблонах | Унижение |
25 | HTTPS без смешанного контента; http → https одним 301 | Консоль браузера; чекер заголовков | Чисто | Ограничение |
26 | Ключевые страницы индексированы и имеют право на снипет: без nosnippetиmax-snippet:0; для полноты - max-snippet:-1иmax-image-preview:large | Проверка URL; поиск nosnippet,max-фрагмент,max-image-preview в коде и в HTTP-заголовке X-Robots-Tag | Снипет разрешен. Это и есть условие показа в AI Overviews и AI Mode - спецфайлы и спецразметка не нужны | Ограничение |
27 | Структурированные данные валидны, без конфликтных типов на одной странице | Rich Results Test; GSC → Улучшение | Один тип сущности на страницу; глубина - в разборе schema для AI-поиска. | Унижение |
Пункт 26 следует перечитать дважды. Вся оптимизация под AI, которую предлагают отдельным счетом, в технической части сводится к этим 27 строкам. Остальное - контент и внешний след, но это уже совсем другое…
Чего чеклист не видит
Теперь честно.
Чеклист - это термометр, а не рентген: он показывает, что температура есть, и ничего не говорит о причине. Сколько ваших зеленых галочек вообще о причинах? Три вещи из этих 27 пунктов не видно в принципе - и мы знаем это не по теории, а по логам реального проекта 2026 года, с которым работали.
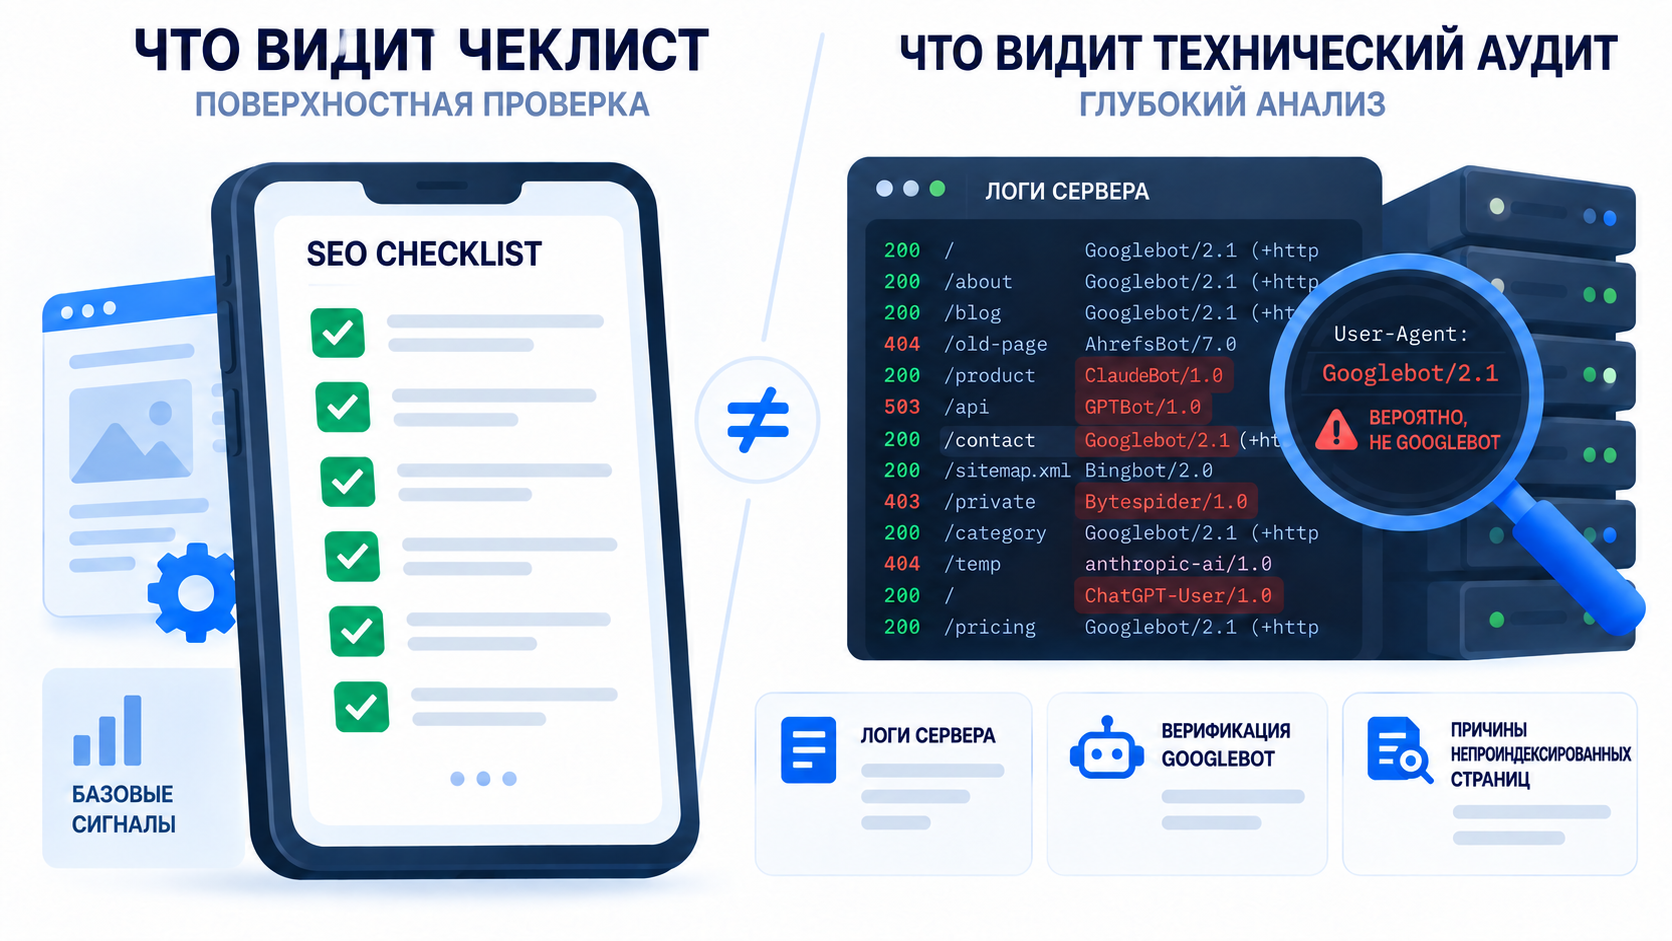
Кто действительно ходит по сайту. В чеклисте вы смотрите Crawl Stats, и там все хорошо. А в серверных логах за двое суток из 937 строк с подписью Googlebot настоящих оказалось 333 - остальные 604, из 464 разных IP, подделка. Любая цифра «как часто нас сканирует Google», снятая по строке User-Agent, недостоверна по умолчанию. Google документирует единственный способ проверки - обратный DNS-запрос с последующей прямой проверкой. Без логов этого не сделать.
Куда следует ресурс сервера. На том же проекте 71,9% всех запросов за два месяца генерировал собственный стек оптимизации сайта - плагин кэширования и чекер ссылок - всплесками по миллиону запросов за четыре дня. Робот при этом не пострадал и Search Console не показала ничего. Но это узнаешь только из логов.
Почему Google не берет прочитанную страницу. 335 URL со статусом «просканирована или обнаружена, не проиндексирована» - 76 % всех непроиндексированных на сайте. Первая гипотеза всегда «мало текста». Мы проверили: 78% этих страниц имеют достаточный объем, самая большая группа - 107 страниц по 800-1500 слов. Дело не в длине. Дело в том, как Google оценивает ценность страницы относительно остального сайта, а это не измерить ни одним пунктом чеклиста - только перекрестным анализом GSC, логов и полного краулинга.
Типичная история по практике: инхаус-команда магазина проходит чеклист, все зеленое, а новые категории два месяца висят вне индекса. Причина нашлась в логах - и она не имела никакого отношения к тем 27 пунктам. Именно для таких случаев и существует технический аудит, а не для того чтобы повторить чеклист за деньги.
Что видит чеклист | Что видит аудит |
|---|---|
robots.txt как текст | Реальная активность каждого бота в логах, с верификацией по IP |
Статусы в Search Console | Причины по статусам: почему именно эти URL Google решил не брать |
Оценку PageSpeed Insights | Полевые данные по сегментам: категории, карты, мобильные из медленных сетей |
Строка User-Agent | Обратный DNS: настоящий Googlebot или 464 подлога |
Один источник на каждый пункт | Каждая находка подтверждена двумя независимыми источниками |
Что делать со списком находок
У вас будет от 3 до 15 меток. Не исправляйте «что проще». Сначала все с классом Blocking - оно возвращает страницы в индекс; затем Limiting - снимает потолок; Degrading - напоследок. Порядок работ повторяет порядок обработки сайта поиском, иначе вы месяц правите Title на страницах, которых нет в индексе.
И сразу развеем ожидания. Сроков переиндексации Google не документирует, поэтому любое «за две недели вернемся в топ» - гипотеза, а не обещание.
Если Blocking-находок больше трех, или вы не можете объяснить, почему категории имеют статус «просканированный, но не проиндексированный», - это уже не чеклист. Это аудит. Как выглядит его результат - приоритетный план от Critical до Low с оценкой влияния на доход, а не PDF на сто страниц - мы показали на кейсе восстановления видимости интернет-магазина.
Как мы это делаем в ADS group
ADS group работает с 2011: Digital-агентство №1 в Николаеве, ТОП-30 Украины, клиенты в Украине и ЕС. Этот чеклист - первый шаг нашего технического аудита, и мы отдаем его полностью: 30-40% находок вы закроете сами. Наша работа начинается там, где заканчивается видимость извне: серверные логи, полный краулинг и правило - ни одна находка не попадает в отчет без подтверждения из двух независимых источников. Исправление ведет та самая связка SEO-юнита и разработчиков, делавшая диагностику, - для Magento, Shopify, OpenCart, WooCommerce, а при необходимости и разработка сайта технические требования с первого дня.
Время - сами, остальные - с логами
Кратко. 27 пунктов по четырем этапам закрывают все, что видно извне, - в 2026-м включая доступ AI-ботов и право на снепет. Классы Blocking → Limiting → Degrading задают порядок исправлений. А три вещи - настоящий Googlebot, распределение ресурса и причины «не проиндексированы» - не видно никому без серверных логов.
Прошли чеклист и нашли больше трех Blocking или непонятный провал индексации? Закажите технический аудит: за 5 рабочих дней - приоритетный план с подтверждением каждой находки двумя источниками и порядком работ, повторяющим порядок обработки сайта поиском.


